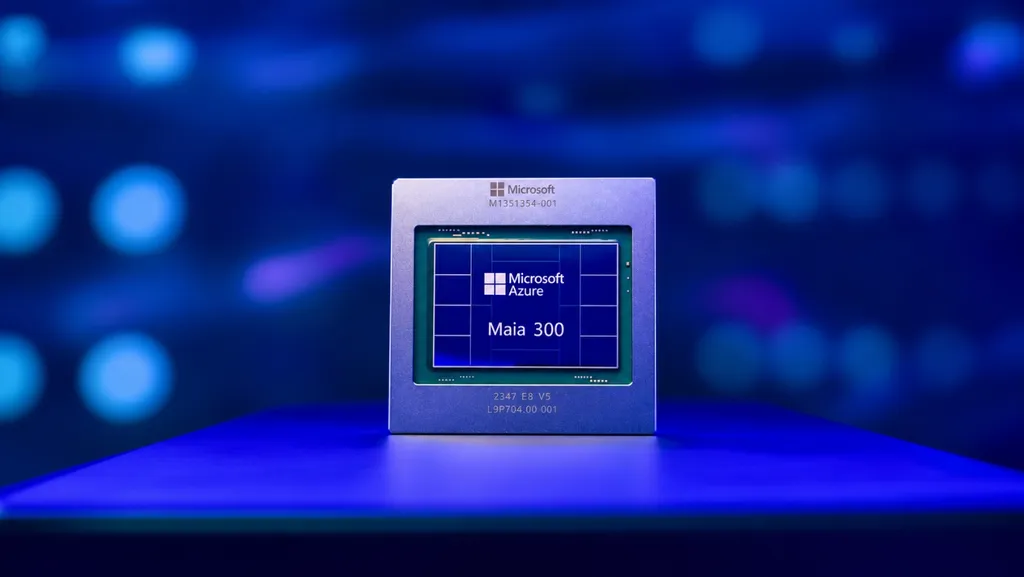
마이크로소프트가 자체 개발한 AI 추론 가속기 라인업을 대대적으로 확장한다. 회사는 차세대 시스템인 'Azure Maia 300'의 생산 배치를 오는 2027년부터 시작하며, 멀티기가와트 규모로 인프라를 넓혀갈 계획이다. 전 세계적으로 치솟는 AI 연산 수요 속에서 외부 의존도를 낮추고 자체 효율성을 끌어올리겠다는 행보다.
이미 실전 투입이 시작된 전작 Maia 200은 코파일럿(Microsoft Copilot)을 비롯해 내부 MAI 팀의 차세대 모델 개발 현장에서 구동되고 있다. 깃허브 코파일럿과 마이크로소프트 파운드리 등 주요 서비스에도 연내 적용을 앞두고 있다. 오픈AI 모델은 물론 자사 MAI 모델과 주요 오픈소스 모델까지 두루 소화하는 구조다.
새롭게 베일을 벗은 Maia 300은 장문 맥락 처리와 지연시간에 민감한 대화형 서비스, 다단계 에이전트 작업을 정조준했다. 추론 효율을 극대화하는 데 초점을 맞춘 설계다. 마이크로소프트는 주요 그래픽처리장치(GPU) 기반 시스템과 비교했을 때 메가와트당 토큰 처리량이 40%가량 높을 것으로 내다봤다. 가속기 96개를 엮은 전체 구성에서는 전작인 Maia 200보다 랙 단위 토큰 처리량이 최대 7배까지 치솟는다.
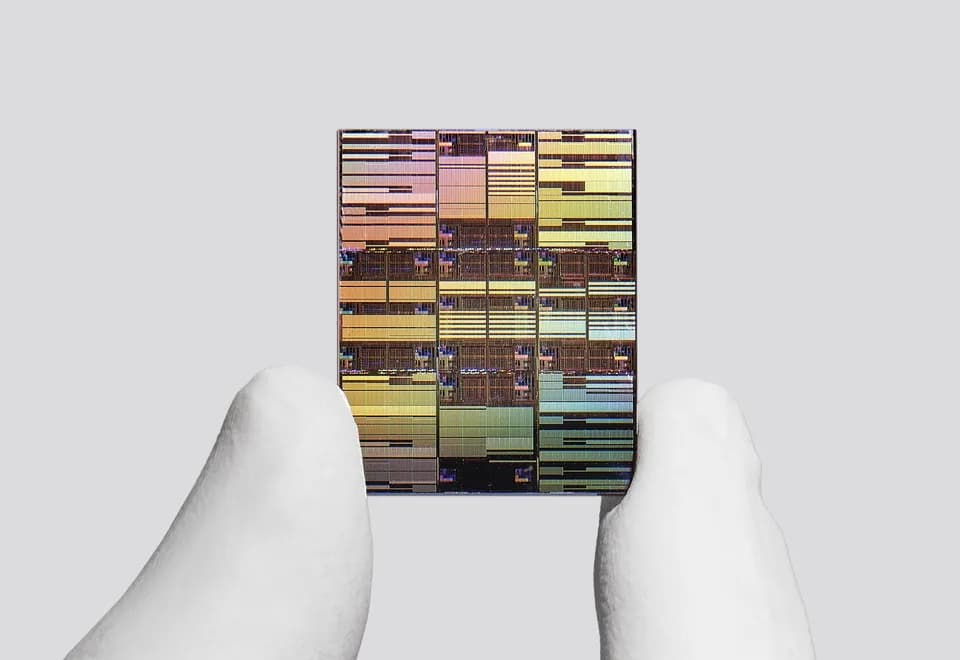
하드웨어 스펙도 눈에 띈다. HBM4 스택 8개를 얹어 950와트 전력 설계 전력(TDP) 안에서 최대 초당 18.0테라바이트의 메모리 대역폭을 뿜어낸다. 연산 장치와 메모리 컨트롤러, 입출력 기능을 쪼갠 멀티칩렛 구조를 택했으며, 핵심 연산 칩렛은 대만 TSMC의 N2P 공정에서 찍어낸다.
단일 랙 시스템은 167킬로와트 전력 환경에서 96개의 가속기를 품는다. 총 HBM 용량은 27.6테라바이트, 합산 대역폭은 초당 1.7페타바이트에 달한다. 고속 스케일업 도메인과 이더넷 기반 네트워크를 통해 단일 랙에서 데이터센터 전체 규모까지 유연하게 덩치를 키울 수 있다.
마이크로소프트는 미국과 유럽, 호주 등 주요 거점에 Maia 200을 이미 심어두었다. 팀즈와 코파일럿 등에서 주요 GPU 인프라 대비 와트당 토큰 처리량이 최대 1.7배에 이른다는 설명이다. 현장에서 쌓은 운영 데이터는 차세대 모델 설계에 고스란히 반영됐다.