기존에는 데이터 레이크 구조를 바꾸려면 별도의 파이프라인을 짜거나 컴퓨팅 자원을 직접 띄워가며 복잡한 변환 작업을 거쳐야 했다. 이번에 공개된 기능은 아마존 S3에 쌓여 있고 AWS 글루(AWS Glue) 데이터 카탈로그에 등록된 파케트(Parquet) 포맷의 테이블을 타깃으로 삼아 전환 과정을 자동화한다.
동작 방식은 체계적이다. 시스템은 실제 데이터를 복사하기 앞서 원본 객체를 정확히 훑고 호환성 보고서를 먼저 뽑아낸다. 데이터 검증부터 자료형 변환, 파일 재압축과 병합까지 마이그레이션에 필요한 실무 절차를 내부적으로 처리한다.
특히 원본 테이블에 새로운 쓰기 작업이 들어오는 상태에서도 필요한 만큼 증분 동기화를 반복할 수 있어 현장 운영 중단 시간을 최소화한다. 최종 단계에서만 수분 정도 쓰기를 멈추고 전환을 마무리하면 된다.
과금 구조도 합리적으로 짰다. 하이브에서 아이스버그로 형태를 바꾸는 변환 연산 자체에는 따로 돈을 물리지 않고, 실제로 복사된 데이터 양에 대해서만 비용을 부과한다. 원본 객체가 S3 인텔리전트 티어링(Intelligent-Tiering)에 묶여 있다면 기존에 쓰던 접근 계층 성격도 그대로 유지된다.
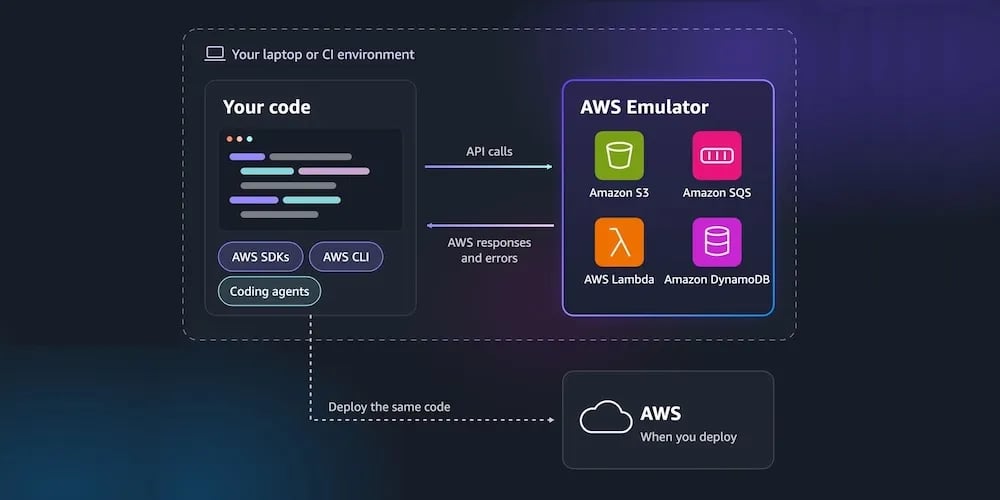
현장 엔지니어들은 웹 콘솔뿐만 아니라 AWS CLI나 SDK, 에이전트 툴킷 등을 입맛에 맞게 골라 쓸 수 있다. 시작 명령을 던진 뒤 완료 시점까지 필요한 만큼 동기화 명령을 호출해 바뀐 내용만 빠르게 반영하는 식이다.
다만 출시 초기에는 몇 가지 제약이 있다. 현재는 동일한 AWS 계정과 같은 리전 안에 있는 글루 등록 하이브 테이블의 파케트 데이터만 지원한다. 서비스가 열린 리전은 미국과 아시아 태평양, 유럽 내 주요 거점들이다