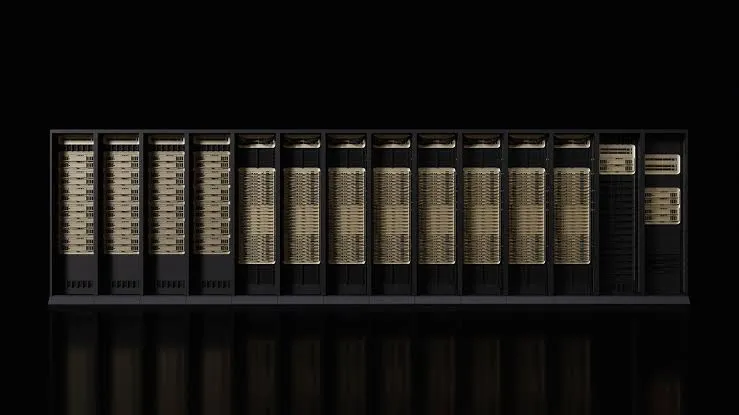
인공지능(AI) 가속기 시장의 판도를 가를 차세대 플랫폼의 성능이 수치로 입증됐다. 엔비디아(NVIDIA)가 공개한 최신 벤치마크 결과는 단순한 하드웨어 스펙 경쟁을 넘어 대규모 데이터 처리와 에이전트 구동 능력을 실증했다.
엔비디아가 16일 발표한 MLPerf 벤치마크 결과는 베라 루빈(Vera Rubin) 플랫폼의 학습과 후속 학습, 에이전트 추론 성능에 초점이 맞춰졌다. 이번 MLPerf Training v6.1의 모든 벤치마크에서 선도적인 성적을 거뒀으며 전 부문에 결과를 제출한 플랫폼은 엔비디아가 유일하다. AI 모델이 목표 정확도에 도달하는 시간을 측정하는 이 평가에는 대규모 언어 모델을 비롯해 이미지 생성, 추천 시스템, 강화학습 기반 후속 학습까지 포함됐다.
처음 참가한 루빈 NVL72는 최적화된 기존 지비300(GB300) NVL72와 비교해 GPU당 최대 2배의 성능을 기록했다. 딥식-브이쓰리(DeepSeek-V3) 벤치마크에서는 GPU 수를 256개에서 1024개로 늘렸을 때 약 97%에 달하는 확장 효율을 증명했다. GPU 규모를 네 배로 확대하자 학습 소요 시간이 16분에서 약 4분으로 단축됐다. 지비300 시스템의 GPU 1만240개 규모로 실행된 테스트는 마이크로소프트 애저(Azure) 환경에서도 동일하게 참여가 이뤄졌다.
이러한 대규모 학습을 뒷받침하는 핵심 요인은 고속 네트워킹 구조다. 시스템 내부의 GPU를 촘촘히 엮는 엔비링크(NVLink)와 데이터센터 내 시스템들을 연결하는 퀀텀-엑스800 인피니밴드(Quantum-X800 InfiniBand), 스펙트럼-엑스 이더넷(Spectrum-X Ethernet)이 유기적으로 맞물려 작동한다. 이들 통신 기술과 최적화된 소프트웨어가 결합해 수천 개의 칩이 병목 없이 한 몸처럼 움직인다.
실제 에이전트 코딩과 기업 업무 흐름을 가정해 진행된 MLPerf 엔드포인트(Endpoints) 테스트도 눈길을 끈다. 작업의 올바른 완료 여부까지 함께 확인하는 이 시험에서 루빈 NVL72는 지비300 NVL72 대비 전력당 처리량이 10배를 웃도는 수치를 기록했다. 사용자당 평균 초당 50토큰 이상의 상호작용 속도를 공통 최소 기준으로 삼았으며 현재 엠엘커먼스(MLCommons) 검증을 기다리는 잠정 결과다.
이번 평가에는 아수스(ASUS), 시스코(Cisco), 코어위브(CoreWeave), 델 테크놀로지스(Dell Technologies), 구글 클라우드(Google Cloud), 헵타(HPE), 오라클(Oracle), 슈퍼마이크로(Supermicro) 등 20개에 달하는 글로벌 조직이 엔비디아 플랫폼 기반 결과물을 올렸다. 회사는 쿠다(CUDA) 기반 소프트웨어 스택의 지속적인 최적화를 통해 루빈의 잠재력을 계속해서 끌어올릴 방침이다.