앨런인스티튜트포AI(Ai2)가 대규모 인공지능(AI) 연구용 그래픽처리장치(GPU) 클러스터의 고질적인 자원 독점 문제를 해결하기 위해 시간 예산과 계층형 공정 배분을 결합한 새로운 스케줄러를 전격 도입했다. 그간 연구 현장에서 관행처럼 굳어졌던 우선순위 기반 예약 방식에서 벗어나, 프로젝트별 자원 배분을 투명한 예산 체계로 전환한 것이 핵심이다.
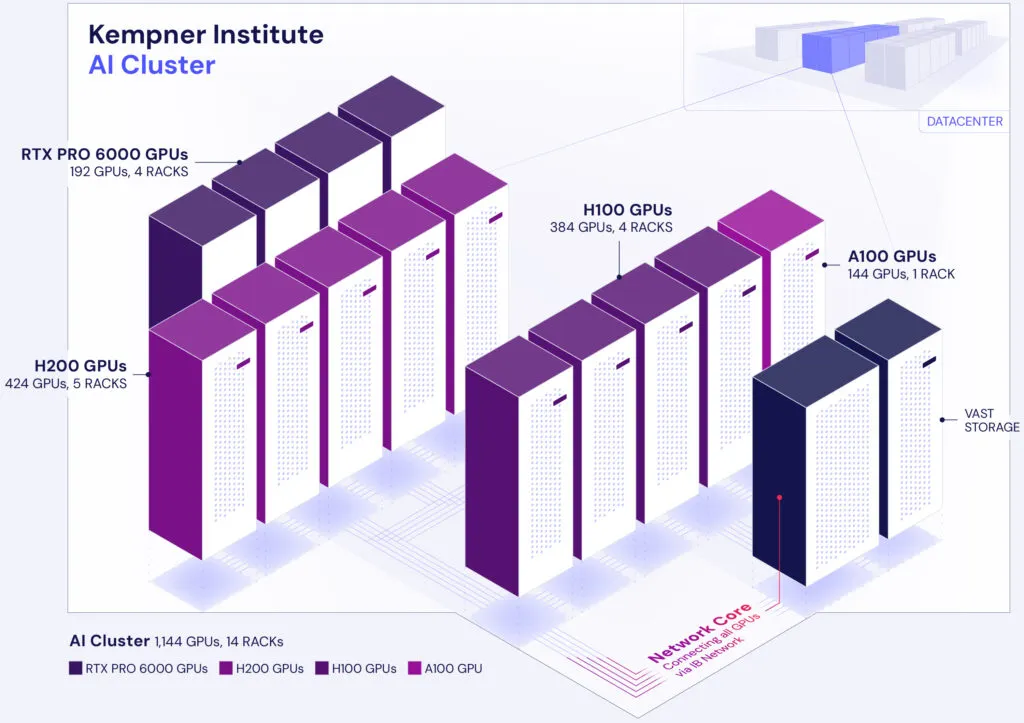
현재 회사는 엔비디아(NVIDIA)의 H100을 비롯해 B200, B300 등 최신 칩 수천 대로 구성된 대규모 클러스터를 운영 중이다. 88개에서 최대 1024개의 GPU를 묶은 이 인프라에는 약 150명의 내부 연구자가 매달려 대형언어모델(LLM) 및 비전언어모델(VLM) 학습, 로보틱스 강화학습 시뮬레이션, 과학 에이전트 후학습 등을 소화하고 있다. 하지만 연구원들이 제출하는 총작업량은 가용 자원의 2배에서 3배에 달해 늘 자원 부족에 시달려 왔다.
기존 시스템에서는 비용 부담 없이 최고 등급의 우선순위를 지정할 수 있어 대부분의 작업이 'HIGH'를 선택하는 왜곡 현상이 벌어졌다. 당장 필요하지 않으면서도 자리를 선점하기 위해 무동작 상태로 GPU를 붙들어 매는 사례도 적지 않았다. 이 때문에 호스트 유지보수가 필요할 때마다 비선점 작업을 중단시키기 위해 엔지니어들이 일일이 조율에 나서야 했고, 이는 연구 생산성을 갉아먹는 주요 원인으로 꼽혔다.
새로운 체계에서는 관리자가 프로젝트별 성격에 맞춰 GPU 시간 비율을 계층적으로 할당한다. 스케줄러는 최근 7일 동안의 실제 점유율을 추적해 배정량을 덜 쓴 작업을 더 많이 쓴 작업보다 우선 배치한다. 예산이 청구되는 작업은 최소 실행 시간 동안 다른 작업으로부터 보호되지만, 배정 시간을 초과한 작업은 언제든 선점될 수 있도록 설계됐다.
연구원들은 작업을 제출할 때 의미 있는 진전을 내기 위한 최소 실행 시간과 재개 가능 여부를 함께 적어낸다. 스케줄러는 이 최소 시간이 지나면 필요에 따라 작업을 잠시 중단하고 다시 대기열에 넣는 방식으로 자원을 회전시킨다. 최소 실행 시간의 상한선은 8시간으로 설정되어 대규모 작업들 사이에서도 시간 분할과 자동 재배분이 원활하게 이뤄진다.
한 달간의 시험 운영 기간 동안 각 연구팀은 자신들에게 할당된 몫의 98%에 달하는 GPU 시간을 안정적으로 공급받았다. 15개 팀 가운데 13개 팀이 95크 이상의 충족률을 기록했고, 가장 낮은 곳도 90%를 밑돌지 않았다. 클러스터 전체 점유율은 개편 전후 모두 98%를 유지해 자원 낭비 없이 촘촘하게 가동됐다.
가장 눈에 띄는 변화는 대기 시간의 급감이다. 디버그 작업의 상위 90% 대기 시간은 기존 2시간에서 30초로 쪼그라들었다. 가장 규모가 큰 H100 클러스터에서도 중앙값 대기 시간이 5분에서 24초로 짧아졌다. 아울러 작업의 최소 실행 시간이 끝나는 시점에 비정상 호스트를 자동으로 비워내는 구조가 안착하면서, 사람이 직접 개입해 수작업으로 처리하던 유지보수 업무도 74%나 줄어들었다.