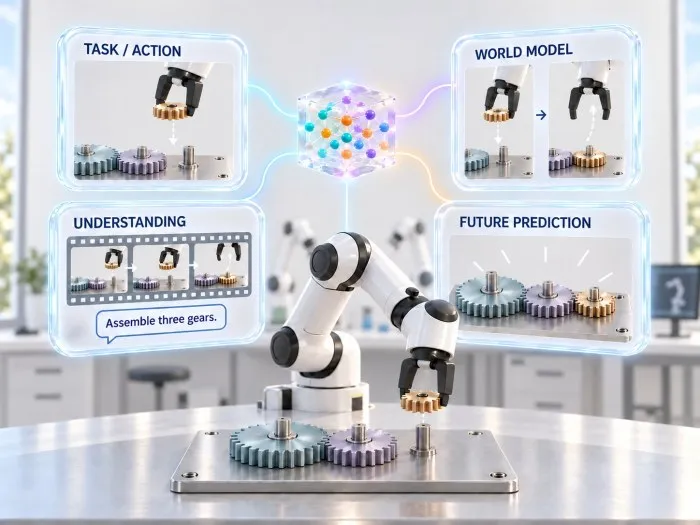
사람의 자연어 지시를 이해하는 수준을 넘어 행동 이후 주변 환경이 어떻게 변할지 미리 그려보고 작업을 수행하는 로봇 인공지능(AI)이 국내 연구진에 의해 개발됐다. 지시를 제어 명령으로 바꾸는 데 그쳤던 기존 방식을 뛰어넘어, 예상되는 행동 결과를 이미지로 그려 이를 로봇 움직임 결정에 직접 활용하는 기술이다.
서울대학교 공과대학 전기·정보공학부 도재영 교수 연구팀(AIDAS 연구실)은 언어와 이미지, 영상, 로봇 행동 데이터를 하나의 모델에서 다루는 로봇 파운데이션 모델 ‘다이닌 로보틱스(Dynin-Robotics)’를 개발했다고 밝혔다. 파운데이션 모델은 범용 데이터를 사전 학습해 다양한 하드웨어와 작업에 적용할 수 있는 기반 AI다.
이번 연구 성과는 AI·기계학습 분야 세계 최고 권위의 국제학술대회인 ‘NeurIPS 2026’에 채택되어 오는 12월 정식 발표를 앞두고 있다. 글로벌 빅테크와 로봇 AI 전문 기업들이 자체 모델을 쏟아내는 상황에서 국내 대학 연구진이 제어 성능과 속도 면에서 모두 우위를 점한 모델을 선보였다.
로봇 하드웨어 성능은 가파르게 개선되고 있지만, 규칙이 정해지지 않은 비정형 환경에서 새로운 지시를 받아 작업을 수행하는 일은 로봇 공학의 오랜 난제다. 정해진 궤적을 반복하는 산업용 로봇과 달리 실제 현장은 물체 위치나 형태, 작업자의 요구가 매번 바뀌기 때문이다. '책상 위 컵을 서랍에 넣고 문을 닫으라'는 지시만 하더라도 컵과 서랍 위치 파악, 물체 이동, 서랍 닫기 등 복잡한 단계별 판단이 요구된다.
최근 학계에서는 대규모 언어모델(LLM)의 언어 이해력을 로봇에 이식하거나 영상 생성 모델로 미래 변화를 예측하는 연구가 활발히 진행되어 왔다. 도 교수 연구팀은 여기서 한 걸음 더 나아가 지시 이해 능력과 행동 결과 예측 능력을 단일 모델 안에서 연동시키는 방식을 취했다.
이번 모델은 연구팀이 앞서 선보였던 옴니모달 AI ‘다이닌 옴니(Dynin-Omni)’를 로봇 제어 영역으로 확장한 결과물이다. 언어, 이미지, 영상, 음성을 하나의 구조에서 처리하는 옴니모달 기술에 로봇 동작 데이터를 결합해 물리적 제어가 가능한 '피지컬 AI'로 발전시켰다.
다이닌 로보틱스의 핵심은 이해·예측·제어를 통합 학습한다는 점에 있다. 작업 영상을 보고 로봇이 수행한 일을 스스로 문장으로 설명할 수 있으며, 통합 학습을 거친 모델은 단순 행동 생성만 학습한 모델에 비해 추상적이거나 은유적인 지시도 훨씬 잘 수행했다. 과일 고르기나 꽃 꽂기 시뮬레이션에서 ‘장미를 꽂으라’는 직접적인 지시뿐 아니라 ‘사랑을 상징하는 꽃을 꽂으라’처럼 맥락적 의미를 지닌 요청에도 정확히 반응했다.
미래 장면 예측 능력은 사람이 물건을 옮기기 전 머릿속으로 배치 모습을 떠올리는 과정과 유사하다. 로봇은 작업 시작 전 입력받은 지시와 현재 시야를 바탕으로 작업이 끝난 후의 목표 장면을 이미지로 미리 생성한다. 이 예측 이미지를 참조해 실제 움직임을 제어하거나 여러 후보 동작 중 가장 적절한 행동을 골라낸다.
행동 생성에 필요한 계산 병목도 크게 개선했다. 연쇄적인 동작에 필요한 정보를 묶어 병렬로 예측하고 연산 과정에서 반복되는 정보를 재활용하는 알고리즘을 적용했다. 그 결과 모델 내부 행동 생성 속도가 기존 대비 최대 29.2배 빨라졌다. 미국 로봇 AI 기업 피지컬 인텔리전스의 ‘파이 제로포인트파이브(π0.5)’와 비교하면 최대 36.6배 빠른 속도다.
실제 로봇을 이용한 조작 평가에서도 독보적인 성과를 냈다. 연구팀은 과일 옮기기, 색상별 블록 분류, 순서 제한 없는 블록 쌓기, 지정 색상 순서 블록 쌓기 등 네 가지 조건에서 실증 평가를 진행했다.
평균 작업 성공률에서 다이닌 로보틱스는 78.4%를 기록하며 이번 실증에 사용된 글로벌 비교 모델들을 모두 제쳤다. 엔비디아의 ‘지알제로제로티(GR00T) N1.6’은 73.0%, ‘코스모스 폴리시(Cosmos Policy)’는 73.6%를 나타냈으며 피지컬 인텔리전스의 ‘π0.5’는 76.9%에 머물렀다.
물류 현장의 비정형 물체 분류나 제조 공정 내 부품 취급 등 사람의 지시와 현장 변수를 동시에 고려해야 하는 상용 환경에 바로 투입될 수 있는 가능성을 입증한 셈이다. 다만 시뮬레이션과 통제된 실험실 환경을 벗어나 복잡한 실제 산업 현장에 적용하기 위해서는 더 다양한 물체와 가변적 환경에서의 검증이 추가로 필요하다.
연구팀은 제조와 물류 현장을 표적으로 부품 조립, 물체 분류 실증을 이어나가는 한편 의료 분야 등으로 적용 범위를 늘릴 방침이다. 세밀한 조작을 위한 로봇 손 제어 기술, 촉각 및 힘 센서 기반의 접촉 상태 파악 기술도 함께 개발 중이다. 서울대학교 의과대학 연구진과는 수술 보조 로봇 및 소화기 내시경 로봇 분야 AI 적용을 위한 공동 연구도 시작했다.
상위 차원의 AI 에이전트 연구도 병행된다. 사람이 “식탁을 치워달라”는 거대 목표를 제시하면 AI가 이를 여러 단계의 세부 작업으로 쪼개 로봇에 분배하고, 작업 실패 시 스스로 이유를 분석해 다른 방법으로 재시도하는 구조다. 이 과정에서 축적되는 성공과 실패 데이터를 학습으로 연결해 '사용할수록 성능이 향상되는 로봇'을 구현하겠다는 목표다.
연구를 이끈 도재영 서울대 교수는 “이번 연구는 로봇이 수행해야 할 작업과 행동 이후 변하게 될 주변 환경, 실제 취해야 할 동작을 하나의 모델에서 통합 처리한다는 데 의미가 있다”며 “실험실을 넘어 현실 세계의 복잡한 지시를 완수하는 실용적 로봇 지능으로 고도화해 나갈 것”이라고 말했다. 이번 연구는 한국연구재단 이공분야 기초연구사업(우수신진) 지원을 받아 수행됐다.