수십만 개의 가속기가 고속 네트워크로 얽힌 거대 AI 팩토리에서는 작아 보이는 이상 징후 하나가 전체 시스템의 발목을 잡곤 한다. 특정 GPU의 온도가 미세하게 상승하거나 NVMe 드라이브의 일시적인 성능 저하가 발생하면 수천억 원대 모델의 훈련 속도가 수십 퍼센트 떨어지기도 한다. 문제는 인프라 덩치가 워낙 크다 보니 어디서 병목이 터졌는지 찾는 데만 며칠씩 걸린다는 점이다.
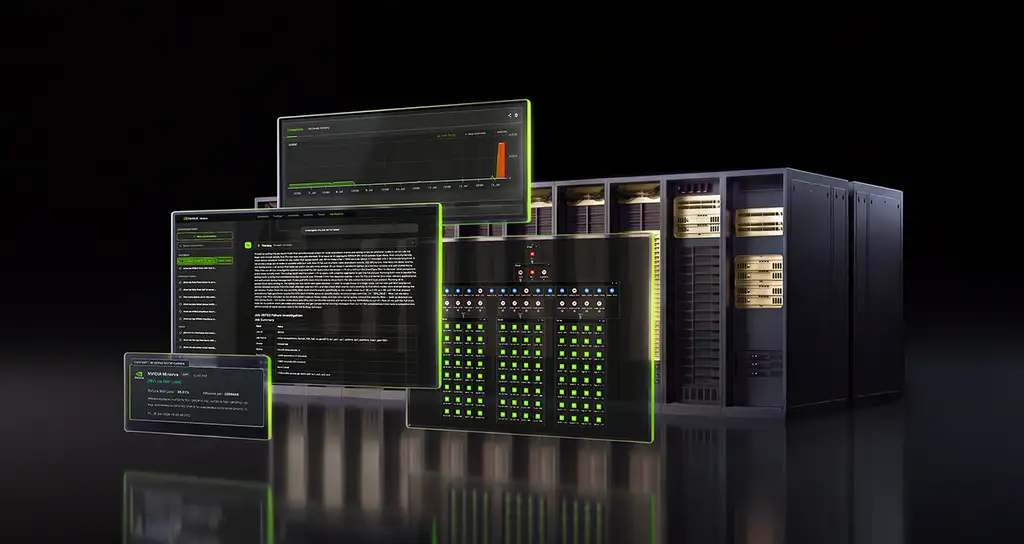
엔비디아가 이러한 인프라 운영 난제를 해결하기 위해 AI 팩토리 전용 관측(Observability) 및 AIOps 플랫폼인 '엔비디아 미네르바(NVIDIA Minerva)'를 정식 공개했다. 미네르바는 인프라 하드웨어와 그 위에서 돌아가는 AI 워크로드의 텔레메트리 데이터를 한데 끌어모은 뒤 전용 AI 모델을 입혀 실시간 조치 정보를 제공한다.
핵심은 단순한 장비 가동률 추적을 넘어 실제 AI 연산의 효율성을 뜻하는 'AI 팩토리 수율'에 집중한다는 점이다. 미네르바는 GPU 사용 시간과 실제 유효 연산량을 뜻하는 굿풋(Goodput), 클러스터 전체 가동 시간, 단위 시간당 생성되는 토큰 생산량을 종합적으로 계산한다.
이를 위해 엔비디아 GPU는 물론 SuperNIC, 스위치, 케이블 등 네트워킹 장비와 스토리지, 잡 스케줄러에서 뿜어져 나오는 신호를 하나로 엮는다. 그 위에서 실행되는 소프트웨어 작업까지 논리적으로 연결해 동적 지식 그래프(Dynamic Knowledge Graph)를 그린다. 수십만 개 GPU로 구성된 초대형 클러스터에서도 특정 훈련 작업이 왜 둔화했는지, 이에 영향을 준 부품이나 네트워킹 노드가 무엇인지를 한눈에 추적할 수 있는 배경이다.
플랫폼은 지도·비지도 머신러닝을 동시에 돌려 시간당 수십억 개에 달하는 데이터 포인트를 실시간 스캔한다. 정상 작동 범위를 스스로 학습한 뒤 전에 없던 미세한 이상 현상을 감지하고, 실제 장애로 이어질 가능성이 높은 신호를 미리 포착한다.
특히 장비 이상 시 수천 개의 경보가 쏟아져 나오는 '알람 폭주' 현상을 방지했다. 클러스터 토폴로지 구조를 기반으로 연관된 이벤트를 하나의 사건으로 묶어낸 뒤, 근본 원인이 될 만한 지점을 짚어 운영자에게 전달한다.
자연어로 인프라 상태를 묻고 답하는 네이티브 AI 어시스턴트도 들어갔다. 실시간 텔레메트리 데이터에 기반한 이 어시스턴트는 외부 에이전틱 AI 도구와 연동된다. 데이터센터 엔지니어가 채팅 창에 클러스터 상태를 물으면 AI가 문제를 진단하고 구체적인 복구 가이드를 제시하는 방식이다. 인프라 API나 기존 자동화 시스템과 연결해 사람이 개입하지 않고도 즉시 복구 작업이 실행되도록 설정할 수도 있다.
글로벌 데이터센터 및 클라우드 기업들의 도입 움직임도 시작됐다. 데이터센터 전문 기업 아이렌(IREN)이 미네르바를 활용해 AI 팩토리 최적화에 나섰으며, 아올라니(Aolani), 비트디어 AI(Bitdeer AI), IBM, 지오(Jio), 람다(Lambda), 퀘이크 AI(Quake AI), 테슬라 등도 도입을 준비 중이다. 델 테크놀로지스를 비롯해 레노버, 슈퍼마이크로는 자사 AI 팩토리 통합 솔루션의 주요 요소로 미네르바를 탑재해 공급할 계획이다.